
Dès que DeepSeek a publié cet article, il a réussi son objectif : il mentionnait le nom d’une entreprise de recherche scientifique, ainsi qu’une affirmation qui semblait sérieuse. L’article était publié juste après la sortie d’une API en même jour. Tous les titres de presse technologiques comparaient ces informations, sans vraiment préciser leur portée. La réaction de quiconque a assisté à des conférences sur les puces et les modèles techniques au fil des années est de se demander ce que va faire l’action en bourse. La réaction est plutôt de se demander ce que cette affirmation signifie réellement, et si quelqu’un a vérifié cette information de manière indépendante.
Le 21 août, DeepSeek a mis en ligne un modèle expérimental appelé deepseek-v4-flash-vision-exp sur sa plateforme API. Il a indiqué que, sur les critères de performance des agents multimodaux, ce modèle représentait une progression importante par rapport à V4-Flash.Les performances de l’agent multimodale sont proches de celles d’Opus-4.8.."
Lisez le reste de cette phrase avant que le mot “close” ne vous excite. Le langage de parité est limité aux benchmarks pour agents multimodaux. L’annonce de DeepSeek indique que le modèle…Les capacités de texte correspondent à sa propre V4-Flash.Sur les agents, la raisonnement et les connaissances du monde – pas ceux d’Opus 4.8. Aucune affirmation concernant l’intelligence générale n’est faite, et le modèle est expressément expérimental. Aucun tableau de benchmarks n’a été publié, et les scores de comparaison utilisés pour valider cette affirmation n’ont pas été divulgués. Vision-exp hérite des fonctionnalités de V4-Flash : les images sont tokenisées en jusqu’à 384 tokens chacune pour les besoins comptables. Il n’y a pas de prix indiqué par million de tokens pour vérifier cela.
Le jugement initial correct n’est pas « DeepSeek a réussi à correspondre avec Opus ». C’est plutôt « DeepSeek affirme cela, mais de manière limitée, sans aucune reproduction indépendante pour l’instant ».Un investisseur perspicace considère la distance entre ces deux phrases comme l’intégralité de l’histoire.
Ce que dit cette mesure indépendante
Le seul indice indépendant disponible à la sortie est l’Index d’Intelligence Artificielle Analytique, qui évalueClaude, Opus 4.8 : 57 contre 52Pour DeepSeek V4 Flash 0731 – la vision-exp du modèle s’étend. Cinq points sont suffisamment importants pour être considérés comme significatifs ; mais pas assez pour être qualifiés de « parité ». En termes d’intelligence générale, Opus 4.8 reste le meilleur. Anthropic a renvoyé Opus 4.8 en mai.Une amélioration modeste, mais tangible.Et cela se situe en tête du classement des leaders – SWE-Bench Pro avec 69,2 %, Terminal-Bench 2.1 avec 74,6 % – c’est précisément là que se situent les tâches à valeur élevée. Le fait de “réduire” un indice ne permet pas de déplacer un seul point de base dans le comportement typique d’une entreprise hors de la maîtrise d’Anthropic. Pas encore.
Mais le concept de “proche” n’a jamais été l’aspect intéressant. Ce qui est intéressant, c’est ce que ces comparaisons révèlent au niveau des prix.
L’écart entre le prix de vente et le prix réel est l’élément principal.
Sur les prix de liste, l’écart est énorme. OpenRouter indique que DeepSeek V4 Flash coûte…0,065 dollars par million de tokens d’entrée, et 0,18 dollars par million de tokens de sortie.Les tokens, par rapport aux prix de 5 et 25 dollars pour Opus 4.8… Cela signifie qu’il est environ 77 fois moins cher en entrée, et 139 fois moins cher en sortie.
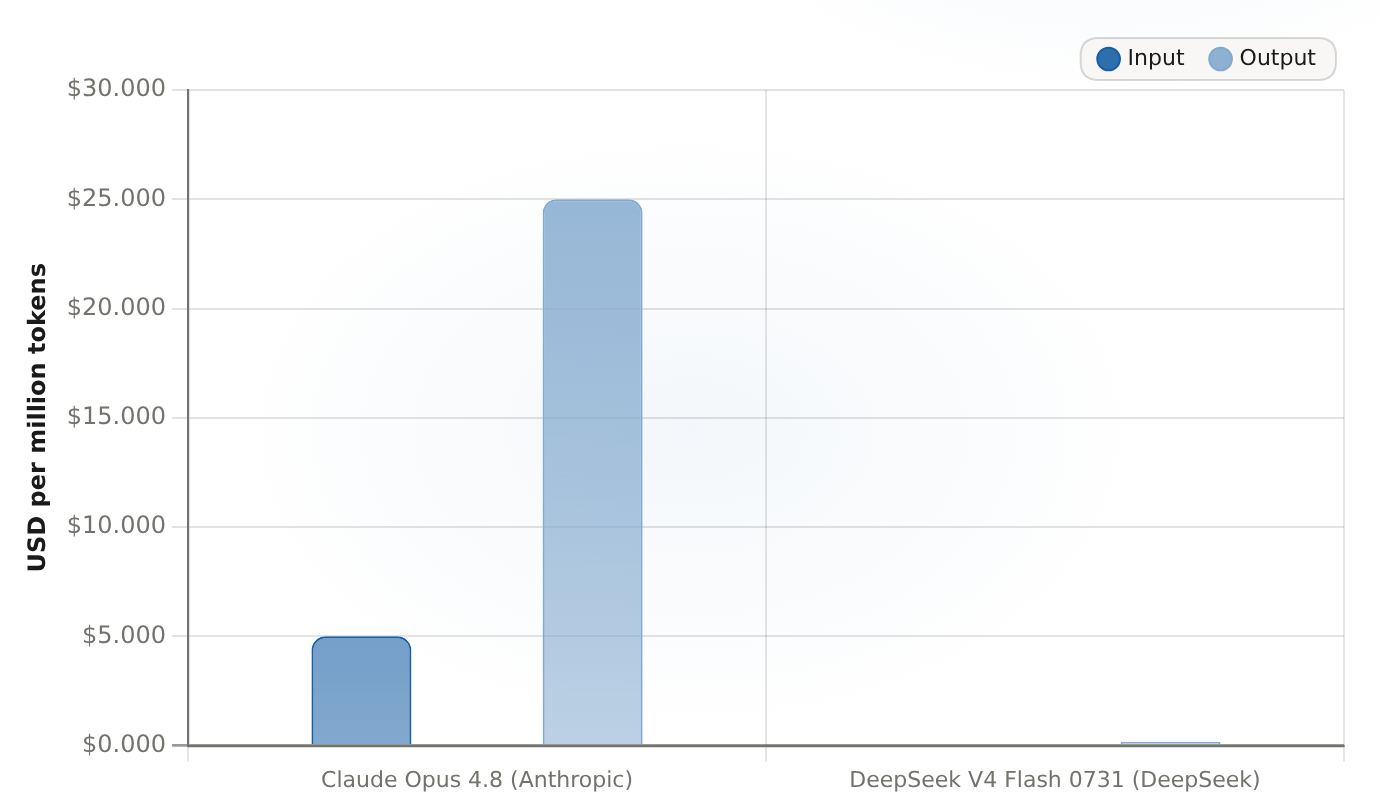
Sur les prix de liste bruts, DeepSeek V4 Flash est environ 77 fois moins cher en termes de tokens d’entrée et environ 139 fois moins cher en termes de tokens de sortie par rapport à Claude Opus 4.8.
| Modèle | Entrée | Résultat |
|---|---|---|
| Claude Opus 4.8 (Anthropique) | 5 | 25 |
| DeepSeek V4 Flash 0731 (DeepSeek) | 0.065 | 0.18 |
La comparaison des listes brutes est importante, car c’est sur cette base que se base la mathématique du marketing. Mais il s’agit d’une base incorrecte pour juger les capacités économiques d’un acheteur réel. Le stockage en cache et une combinaison réaliste de tokens permettent de réduire cette différence. L’analyse artificielle, en calculant le prix effectif par million de tokens, en tenant compte d’un rapport réaliste de 7:2:1 entre les occurrences de cache et les entrées/sorties, montre que DeepSeek coûte environ 0,23 dollar par million de tokens, contre environ 3,85 dollars pour Opus 4,8. Cela signifie une différence de près de 16 fois plus faible, et non 139 fois. En ajoutant également la vitesse de traitement, on obtient une vitesse de sortie de environ 2,1 fois plus rapide (133 tokens par seconde contre 62), et un temps de traitement inférieur de environ 34 fois (1,15 seconde contre 38,78 secondes).
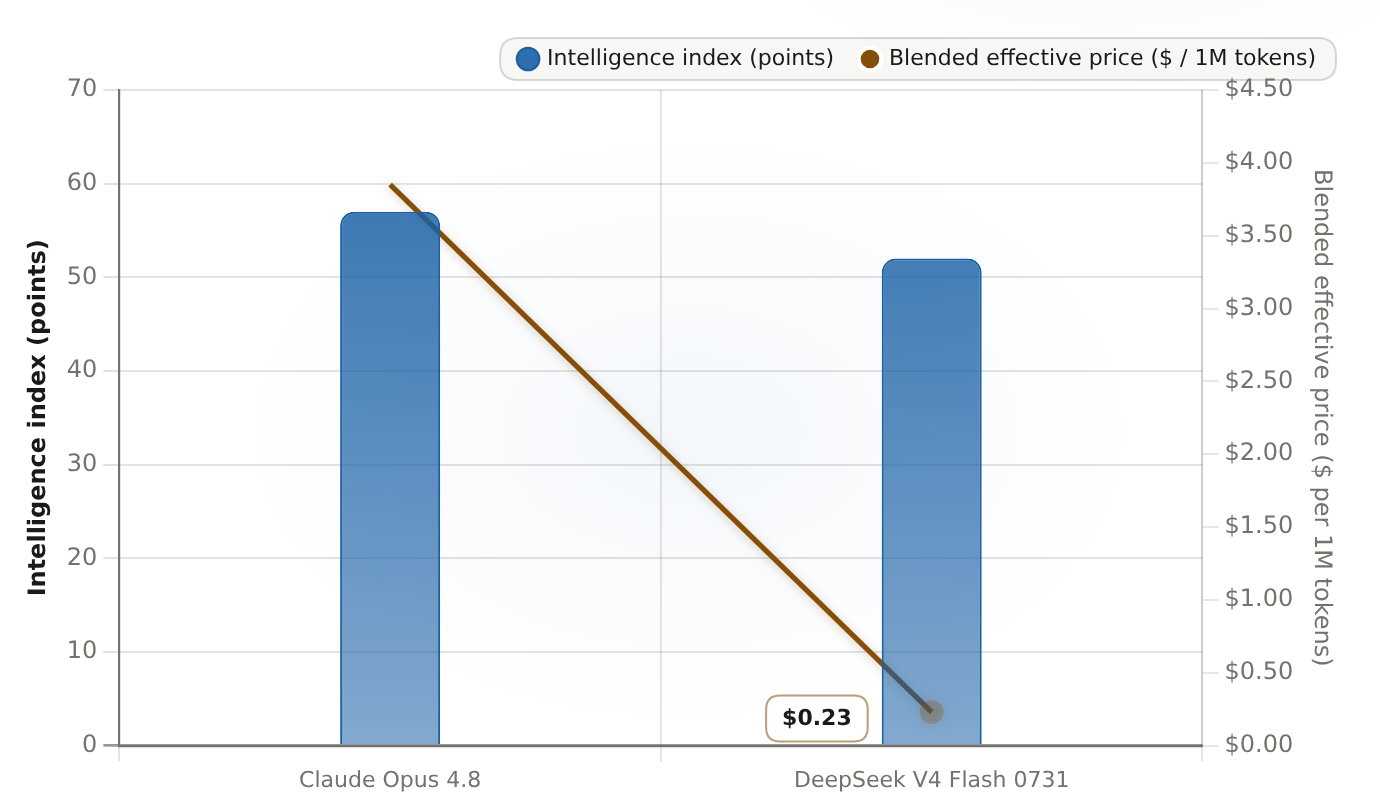
DeepSeek est juste 5 points en dessous de Claude sur l’indice d’intelligence. Cependant, son coût est environ 16 fois inférieur pour chaque million de tokens, selon le prix effectif combiné AIA.
| Modèle | Indice d’intelligence (points) | Prix effectif mixé ($ / 1M tokens) ($) |
|---|---|---|
| Claude Opus 4.8 | 57 | 3.85 |
| DeepSeek V4 Flash 0731 | 52 | 0.23 |
Le « blended » correspond à ce que le directeur financier d’une entreprise de codage à grande échelle paie réellement. Le « listing » représente le pouvoir de tarification dont le laboratoire de recherche se croit détenteur. L’espace entre ces deux choses constitue donc l’arbitrage.Aucune de ces bases n’est le “nombre” en soi ; chacune répond à une question différente. Les deux ne doivent jamais être mises ensemble.
C’est le pouvoir de tarification qui est écrasé.
On construit donc le cadre par unité, et l’objectif de la compression devient évident. Les prix anthropiques sont de 25 $ pour un million de tokens de production ; les prix des substituts structurels sont de 0,18 $. Les marges de Frontier-Lab représentent une taxe sur les tokens, et cette taxe est maintenant protégée par un écart de capacité qui, selon des mesures indépendantes, se situe à cinq points d’indice – pas par une barrière que personne ne peut franchir. Un acheteur d’API qui utilise le même travail de codage agentique avec les deux modèles peut réévaluer un petit échantillon. Lorsque les évaluations indépendantes montrent que l’écart est faible pour son travail spécifique, ils utilisent ce substitut. Cet substitut est donc le mécanisme qui force la prime à diminuer. Les poids ouverts ne peuvent pas être désactivés en changeant la licence, et chaque trimestre de scores convergents représente un trimestre où la taxe devient plus difficile à défendre.
L’efficacité est réelle. Le « miracle » est exagéré.
Le bilan efficace de DeepSeek mérite le respect. Les versions V3 et R1, sorties en janvier 2025, ont atteint…Parité avec GPT-4o et o1, à un prix bien inférieur.Avec R1, qui est presque deux fois plus rapide que o1. Dario Amodei lui-même a admis que DeepSeek a réussi, au moins dans certains domaines, à…Approcher la performance des modèles d’IA frontières américainsÀ moindre coût. C’est le principe d’un laboratoire concurrent qui reconnaît l’existence de l’arbitrage.
Les précisions honnêtes suivent. Le chiffre de 5,576 millions de dollars concernant l’entraînement du modèle V3 ne représente que la partie finale qui a réussi – il ne prend pas en compte les recherches précédentes, les éliminations d’éléments spécifiques et les infrastructures nécessaires. Selon les estimations indépendantes, notamment celles de CSIS, le montant réel est supérieur à 1 milliard de dollars. En citant ce chiffre de 5,576 millions de dollars comme coût des modèles DeepSeek, on transforme ce « miracle » en une actualité médiatique. L’histoire est également entravée par les accusations concernant OpenAI : des preuves trouvées par OpenAI, les observations des chercheurs en sécurité chez Microsoft sur l’exfiltration massive d’informations via les APIs, ainsi que les modèles DeepSeek qui se disent basés sur l’architecture GPT-4… Tout cela soulève la question de savoir quelle part de l’efficacité provient de l’architecture du modèle lui-même, et quelle part provient de signaux empruntés à d’autres modèles. La distillation consiste en l’entraînement d’un modèle étudiant sur les résultats d’un modèle maître plus grand ; si c’est vraiment le principe fondamental, alors l’avantage de coût est en partie emprunté, et non propriétaire.
Le sous-système d’ingénierie est vraiment économique : la famille V4 est un modèle Mixture-of-Experts peu dense.284 milliards de paramètres totauxAvec environ 13 milliards d’activations par token, et un contexte de 1 million de tokens – où chaque étape d’inférence ne touche qu’une petite partie des poids du modèle. DeepSeek a construit ce système en utilisant du silicium de classe H800, mais cela lui a imposé une différence de performance d’environ 4 fois inférieure par rapport aux entreprises américaines.Architecture, pas la chance… mais l’architecture sous un astérisque, jusqu’à ce que la question de la distillation soit résolue.
La thèse du capital investi tient bon face aux critiques.
C’est là que la plupart des investisseurs se trompent de direction. L’intuition est que les tokens moins chers entraînent une dégradation dans le développement de l’IA – un marché qui a fait chuter Nvidia de 18 % en une seule session de janvier 2025, à cause de la panique liée à DeepSeek. Mais les prévisions des hyperscalers indiquent l’inverse. Futurum estime que les dépenses de développement pour les cinq plus grands fournisseurs de services cloud et d’IA aux États-Unis – Microsoft, Alphabet, Amazon, Meta, Oracle – seront…660 milliards à 690 milliardsEnviron deux fois le montant d’environ 380 milliards de dollars pour l’année 2025. Le nombre de fonds de capital-risque liés à Value Add se trouve dans les entreprises Amazon, Microsoft, Alphabet et Meta ; ce chiffre est encore plus élevé.Environ 760 milliards de dollars, soit une augmentation de 85 % par rapport à environ 410 milliards de dollars.Les champs de application sont différents, donc chaque chiffre a sa propre définition. Les cinq fournisseurs décrivent leurs marchés d’IA comme étant soumis à des contraintes d’offre plutôt qu’à des contraintes de demande : Microsoft possède un solde de 80 milliards de dollars sur le service Azure, qui est limité en raison des problèmes techniques ; Alphabet a réduit les coûts de service de Gemini de 78 % entre 2025 et maintenant, tout en continuant à augmenter les prévisions de dépenses en investissements.
Le paradoxe est celui de Jevons : les unités moins chères d’un bien donnent lieu à une consommation totale plus élevée. L’efficacité réduit le coût de chaque unité, mais le volume d’utilisation augmente, et la demande globale en termes d’infernements croît plus rapidement que le coût par unité diminue. L’efficacité ne annule pas l’investissement nécessaire pour mettre en place ces unités ; elle fait plutôt augmenter la charge de travail à assurer. Il vaut mieux le dire clairement à ceux qui ont attendu en 2025, dans l’attente d’un concurrent efficace capable de remettre en question le budget alloué aux investissements en IA :La pénétration ne provient pas de la partie “buildout” de la thèse.

Ce que les preuves laissent sous pression
Le jugement global se divise en deux parties. La construction d’infrastructures se déroule sans problème, grâce à l’efficacité des concurrents. Un investissement de près du double en 2026 est la réponse du marché à cette notion d’efficacité. Ce qui est exposé, c’est le prix par token que Anthropic et OpenAI appliquent à leurs modèles de haute qualité – ce qu’on appelle le pouvoir de tarification au niveau du “frontier-index”. Ce pouvoir repose sur un écart de cinq points sur l’indice, avec un prix de 77x à 139x par token, et une prime combinée d’environ 16x. Il est impossible d’éliminer cette pratique. Notez le déséquilibre entre les chiffres : les revenus annuels d’OpenAI, d’environ 20 milliards de dollars, représentent environ 3 % de l’investissement en 2026 des hyperscalers. Ainsi, la construction d’infrastructures ne dépend pas du maintien de ces coûts.Le volume reste intact ; le pouvoir de tarification est donc l’élément le plus vulnérable.
Liste de regard, de 6 à 12 mois
- Évaluation indépendante du modèle Vision-Exp – Analyse artificielle, LMArena ; réplication externe des scores du agent multimodale. C’est le premier test réel de cette affirmation.
- Il est incertain si DeepSeek publie son tableau de référence et les scores de comparaison. En l’absence de ces informations, l’affirmation « proche de Opus 4.8 » reste incroyablement difficile à vérifier.
- Adoption par les entreprises des API et des poids de DeepSeek – que les charges de travail réelles soient transférées ou non, selon les tests de performance de FinTwit.
- Comment Anthropic et OpenAI réagissent : réductions de prix, modifications concernant les niveaux d’effort, rythme de sortie des versions. Tout changement dans la liste des prix par token est une reconnaissance de la pression exercée sur eux – Anthropic a déjà classé Opus 4.8 Fast Mode dans un niveau de difficulté particulier.10 et 50 dollars par million de tokens, à une vitesse de 2,5x..
- Coût d’inférence par token – il se peut que l’écart combiné diminue ou augmente au cours des deux prochaines trimestres.
Quand cette histoire n’a pas d’importance
- Si l’évaluation multimodale indépendante montre que les données utilisées pour l’évaluation étaient choisies de manière arbitraire, alors l’affirmation devient infondée : « DeepSeek s’est matché à lui-même ».
- Si la dépendance à la distillation se révèle importante, l’argument en faveur de l’efficacité pure est ébranlé, et le écart de prix ne sera pas aussi stable qu’on le pense.
- Si les acheteurs d’entreprises ne remplacent pas Opus 4.8 – si Opus 4.8 reste la solution de référence pour les charges de travail à haute valeur et à haut risque – alors les coûts resteront les mêmes.
- Si Anthropic et OpenAI répondent plus rapidement que la substitution progresse, le premium se défendra.
L’analyse à niveau investisseur est une opération qui combine différentes tendances, avec une orientation déterminée. Les coûts de construction sont payés en fonction du volume, et survivent aux concurrents efficaces. Mais le coût par token qui finance les marges et les évaluations des entreprises innovantes ne semble pas durable lorsque le premium atteint 16x à 139x, alors que l’écart de compétence indépendant est de cinq points sur l’indice, et que les alternatives sont ouvertes. Il faut observer le chiffre combiné, plutôt que le score d’indice – l’arbitrage existe là où le coût est réellement collecté.








Commentaires
Pas encore de commentaires