
En el momento en que DeepSeek publicó ese texto, éste cumplió su función. Contenía un nombre relacionado con la investigación en este campo, además de una afirmación de “cerca de”. La publicación ocurrió en el mismo día en que se lanzó la API. Todas las noticias tecnológicas compararon esa afirmación, pero no explicaron sus detalles. Lo que todos hacen cuando ven discursos sobre chips y modelos tecnológicos es preguntar qué va a hacer la empresa en los próximos días. En realidad, lo que buscan es saber qué dice realmente esa afirmación, y si alguna persona independiente la ha verificado.
El 21 de agosto, DeepSeek puso en funcionamiento un modelo experimental llamado deepseek-v4-flash-vision-exp en su plataforma de API. Dijo que, en los “benchmarkes de agentes multimodales”, lograba “un gran avance respecto a V4-Flash”.El rendimiento del agente multimodal está cerca de Opus-4.8.."
Lea el resto de esa oración antes de que la palabra “close” te emocione. El lenguaje de paridad está limitado a los criterios de evaluación para agentes multimodales. El anuncio de DeepSeek dice que el modelo…Las capacidades de texto coinciden con su propio V4-Flash.En cuanto a los agentes, el razonamiento y el conocimiento del mundo… no se trata de lo que incluye Opus 4.8. No se afirma nada sobre la inteligencia general. El modelo es, expresamente, de carácter experimental. No se publicó ninguna tabla de puntuaciones de referencia, y las puntuaciones comparativas utilizadas para evaluar el modelo tampoco fueron divulgadas. Vision-Exp hereda las características de V4-Flash: cada imagen está tokenizada en hasta 384 tokens, para fines de contabilidad. No existe un precio separado por millón de tokens para verificarlo.
El juicio correcto en primer lugar no es “DeepSeek coincidió con Opus”. Es más bien: “DeepSeek afirma algo, pero de manera limitada, sin que haya ninguna prueba independiente aún”.Un inversor astuto considera la distancia entre esas dos oraciones como toda la historia.
Lo que dice esa medida independiente.
El único índice independiente disponible en el momento de su publicación es el Índice de Inteligencia Analítica Artificial, que otorga puntuaciones…Claude Opus 4.8: 57 contra 52Para DeepSeek V4 Flash 0731: la visión del modelo se extiende. Cinco puntos es suficientemente importante, pero no lo suficiente para considerarlo como un estándar de paridad. En términos de inteligencia general, Opus 4.8 sigue siendo el líder del campo. Anthropic entregó Opus 4.8 en mayo.Un mejoramiento modesto pero tangible.Y se encuentra en la cima de la lista de líderes en cuanto al porcentaje de éxito: SWE-Bench Pro con un 69.2 por ciento, Terminal-Bench 2.1 con un 74.6 por ciento. Eso es precisamente el tipo de entorno en el que se realizan las tareas de alto valor. “Cercano” a un índice no significa que se mueva ni un solo punto base del comportamiento típico de una empresa fuera de los controles de Anthropic. Todavía no.
Pero “cercano” nunca fue el aspecto interesante. Lo importante es lo que las mismas comparaciones revelan en cuanto al precio.
La brecha entre el precio de lista y el precio real es lo más importante.
En los precios de lista iniciales, la diferencia es enorme. OpenRouter lista el DeepSeek V4 Flash a$0.065 por millón de tokens de entrada y $0.18 por millón de salidaLos tokens, en comparación con los precios de $5 y $25 del Opus 4.8. En total, es aproximadamente 77 veces más barato en el ingreso y 139 veces más barato en la salida.
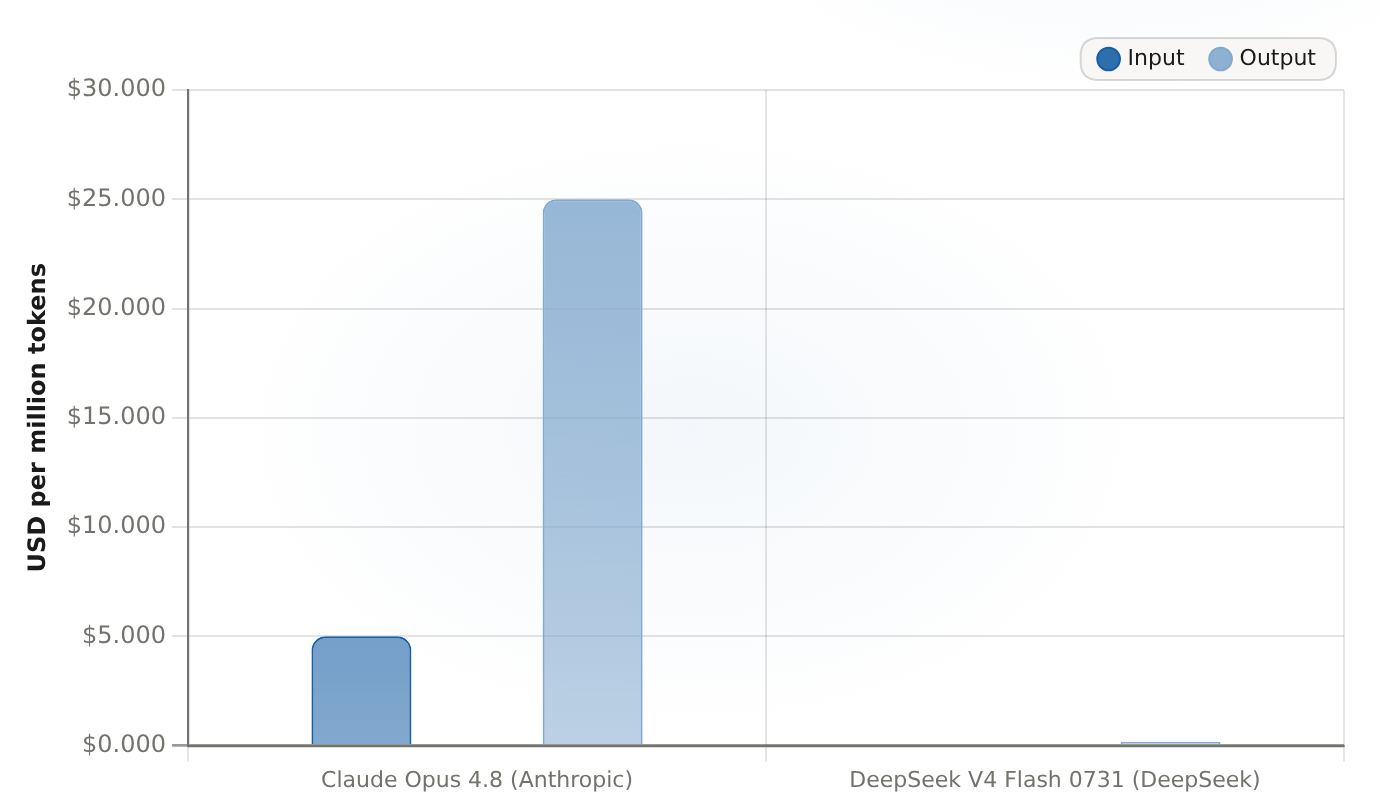
Según los precios iniciales de la lista, DeepSeek V4 Flash es aproximadamente 77 veces más barato en cuanto a tokens de entrada y aproximadamente 139 veces más barato en cuanto a tokens de salida, en comparación con Claude Opus 4.8.
| Modelo | Entrada | Resultado |
|---|---|---|
| Claude Opus 4.8 (Anthropic) | 5 | 25 |
| DeepSeek V4 Flash 0731 (DeepSeek) | 0.065 | 0.18 |
La comparación directa de las listas es importante, ya que es sobre esta base que se basan los cálculos de marketing. Pero esa es una base incorrecta para juzgar la eficiencia económica de un comprador real. El almacenamiento en caché y una combinación realista de tokens pueden reducir esa diferencia. El “precio efectivo” calculado mediante análisis artificial – una cifra por millón de tokens, ponderada según la relación realista de 7:2:1 entre cachés y procesamiento de datos – indica que DeepSeek cuesta aproximadamente $0.23 por millón de tokens, en comparación con $3.85 para Opus 4.8. Es decir, DeepSeek es aproximadamente 16 veces más barato, no 139 veces. Sumando la velocidad de procesamiento y las mismas características de capacidad, se obtiene una velocidad de salida aproximadamente 2.1 veces mayor (133 tokens por segundo contra 62), y un tiempo de procesamiento aproximadamente 34 veces menor (1.15 segundos contra 38.78).
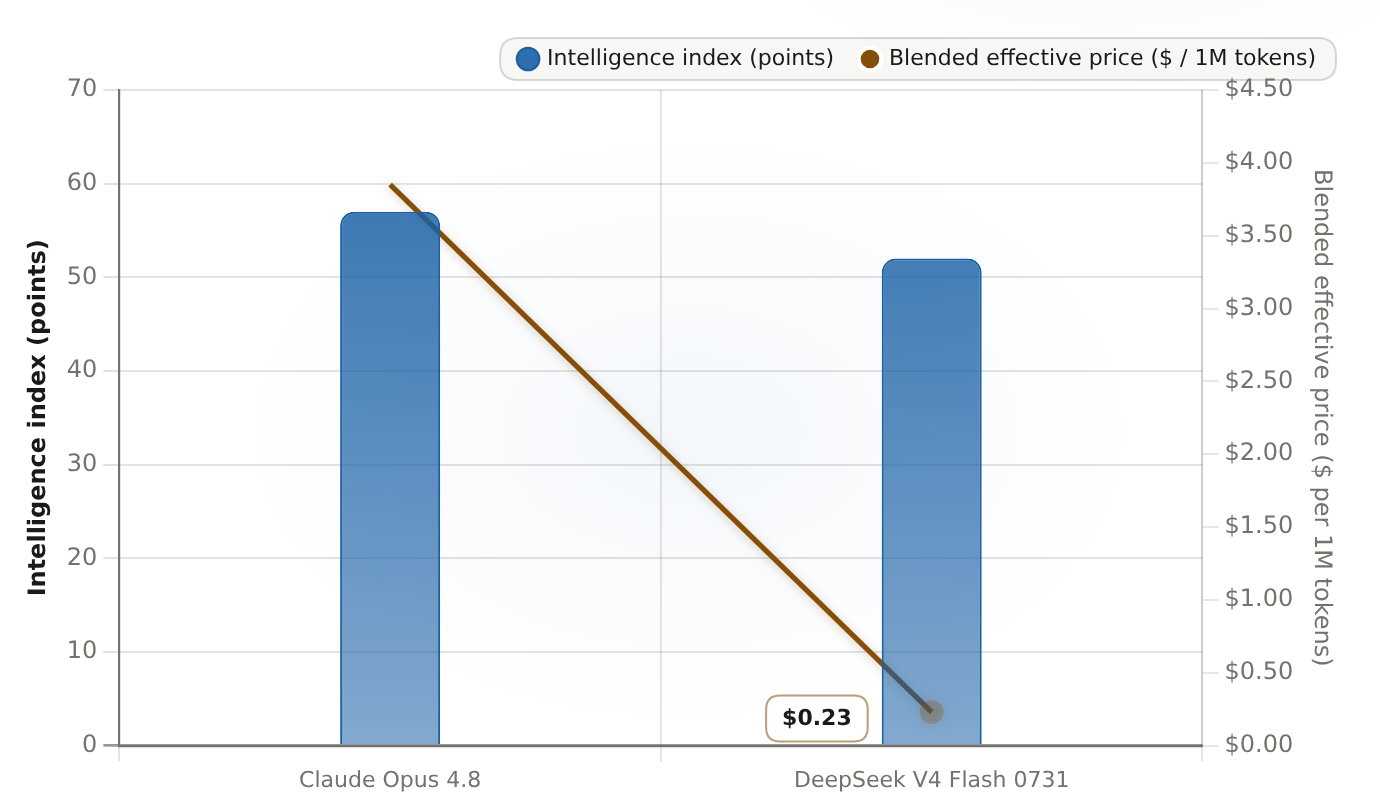
DeepSeek está a solo 5 puntos por detrás de Claude en el índice de inteligencia. Pero su precio es aproximadamente 16 veces menor por millón de tokens, según el precio efectivo combinado de AIA.
| Modelo | Índice de inteligencia (puntos) | Precio efectivo combinado ($ / 1M tokens) ($) |
|---|---|---|
| Claude Opus 4.8 | 57 | 3.85 |
| DeepSeek V4 Flash 0731 | 52 | 0.23 |
“Blended” es lo que realmente paga un CFO de una empresa de codificación de alto volumen. “List” es el poder de fijación de precios que la empresa frontier lab cree que posee. El espacio entre ambos es el arbitraje.Ninguno de los dos es “el” número; cada uno responde a una pregunta diferente, y los dos no deben confundirse nunca.
El poder de fijación de precios por token es lo que se ve afectado.
Se construye el marco por unidad, y el objetivo de la “squeeze” se vuelve evidente. Los precios antropicos asignan un millón de tokens de producción a $25; los substitutos estructurales los valoran en $0.18 en lista. Los márgenes de Frontier-lab son una tarifa adicional para los tokens, y esa tarifa ahora está protegida por una brecha de capacidad que las mediciones independientes indican como cinco puntos en el índice. Un comprador de API que utiliza el mismo trabajo de codificación agentica en ambos modelos puede volver a evaluar una muestra pequeña. Cuando las evaluaciones independientes demuestran que la brecha es pequeña para su trabajo específico, ellos sustituyen ese modelo. Esa sustitución es el mecanismo que fuerza a la prima a reducirse. Las pesas abiertas no pueden desactivarse con un cambio de licencia, y cada cuarto de puntajes convergentes significa que la tarifa se vuelve más difícil de defender.
La eficiencia es real. El “milagro” es exagerado.
El récord de eficiencia de DeepSeek merece respeto. V3 y R1, lanzados en enero de 2025, lograron…Paridad con GPT-4o y o1, por una fracción del costo.Con R1, casi el doble de rápido que o1. El propio Dario Amodei admitió que DeepSeek ha logrado, al menos en algunos aspectos, hacerlo.Cerca del rendimiento de los modelos de IA de frontera de EE. UU.A un costo más bajo. Ese es el principio de un laboratorio competitivo en la frontera, que reconoce que existe el arbitraje.
Luego vienen los detalles honestos. La cifra de 5.576 millones de dólares relacionada con el entrenamiento del modelo V3 solo abarca la fase final de entrenamiento que fue exitosa. Esto excluye las investigaciones previas, las infraestructuras utilizadas y las estimaciones independientes, como las de CSIS. Las estimaciones indican que el total real supera los 1 mil millones de dólares. Al referirse a esa cifra de 5.576 millones de dólares como costo de los modelos de DeepSeek, ese “milagro” se presenta como algo importante para los medios de comunicación. La historia también está influenciada por las acusaciones contra OpenAI: “algunas pruebas” de OpenAI, las observaciones de los investigadores de seguridad de Microsoft sobre la transferencia masiva de datos a través de APIs, y los modelos de DeepSeek que indican que están basados en la arquitectura GPT-4. Todo esto plantea la pregunta de cuánto de la eficiencia proviene de la arquitectura del modelo y cuánto proviene de señales provenientes de otros modelos. La distilización consiste en entrenar un modelo estudiante a partir de los resultados de un modelo maestro más grande. Si ese es el verdadero mecanismo, la ventaja económica es parcialmente “arrendada”, no propia.
El subsistema de ingeniería es realmente económico: la familia V4 es un modelo Mixture-of-Experts poco complejo.284 mil millones de parámetros en total.Con aproximadamente 13 mil millones de activaciones por token y un contexto de 1 millón de tokens; en cada paso de inferencia, solo se toca una pequeña parte de los pesos. DeepSeek utilizó silicio de clase H800 para desarrollar este sistema, pero tuvo que aceptar una desventaja en el cálculo de los procesos informáticos, aproximadamente 4 veces mayor, en comparación con las empresas estadounidenses.Arquitectura, no suerte… Pero arquitectura bajo un asterisco, hasta que se resuelva la cuestión relacionada con la destilación.
La tesis del gasto inicial sobrevive a los desafíos.
Es aquí donde la mayoría de los inversores se equivocan en sus decisiones. La interpretación instintiva es que los tokens más baratos podrían obstaculizar el desarrollo de la inteligencia artificial. Ese movimiento de mercado causó una caída del 18% para Nvidia en una sola sesión de enero de 2025, debido al pánico relacionado con DeepSeek. Pero las recomendaciones de los grandes proveedores de servicios en la nube y de inteligencia artificial indican lo contrario. Futurum estima que el gasto en capital de operaciones para los cinco principales proveedores de servicios en la nube y de inteligencia artificial en Estados Unidos en 2026 será…660 mil millones a 690 mil millonesCasi duplica los aproximadamente 380 mil millones de dólares en 2025. El valor de las inversiones realizadas por Value Add VC en empresas como Amazon, Microsoft, Alphabet y Meta es aún mayor.Alrededor de 760 mil millones de dólares, un aumento del 85% en comparación con los aproximadamente 410 mil millones de dólares.Los alcances son diferentes, por lo que cada número tiene su propia definición. Los cinco proveedores describen sus mercados de IA como aquellos con restricciones en la oferta, y no en la demanda. Microsoft tiene un inventario de Azure de 80 mil millones de dólares, que está limitado por cuestiones relacionadas con la capacidad de producción. Alphabet redujo los costos de servicio de Gemini en un 78% durante el año 2025, pero siguió aumentando las proyecciones de inversión en capital de explotación.
El paradójico es Jevons: las unidades más económicas de un bien determinado aumentan el consumo total. La eficiencia reduce el costo de producción de cada unidad, mientras que el volumen de uso aumenta. La demanda total de producción aumenta más rápido que el costo por unidad disminuye. La eficiencia no elimina la necesidad de construir nuevas instalaciones; simplemente multiplica la carga de trabajo que estas deben soportar. Vale la pena decirlo claramente para aquellos que no participaron en 2025, esperando a que algún competidor eficiente reduzca los costos de inversión en IA:La punción no proviene del lado de la construcción del trabajo de tesis.

Lo que las pruebas dejan bajo presión
La decisión neta se divide en dos partes. La construcción de la infraestructura sobrevive al impacto del competidor eficiente; el gasto en capital de riesgo cercano al doble para el año 2026 es la respuesta del mercado a la narrativa de eficiencia. La parte expuesta es el precio por token que Anthropic y OpenAI mantienen en sus modelos de alta calidad: lo que la empresa llama “poder de precios en el índice fronterizo”. Este precio se basa en una diferencia de cinco puntos en el índice, con un precio de 77x a 139x en relación con el precio total, y aproximadamente 16x en términos de precio combinado. No se puede eliminar este factor. Tenga en cuenta la discrepancia de escalas: los ingresos anuales de OpenAI, que son de aproximadamente 20 mil millones de dólares, representan aproximadamente el 3% del gasto en capital de riesgo de los hiperescalers para el año 2026. Por lo tanto, la construcción de la infraestructura no depende de este costo adicional.El volumen sigue existiendo; el poder de fijación de precios es el aspecto más vulnerable.
Lista de películas para ver, de 6 a 12 meses
- Evaluación independiente de Vision-Exp: análisis artificial, replicación externa de los puntajes del agente multimodal. Este es el primer verdadero test de esta afirmación.
- Si DeepSeek publica su tabla de referencia y los puntajes de comparación. En ausencia de eso, “cerca de Opus 4.8” sigue siendo inverificable.
- Adopción de las API y pesos de DeepSeek por parte de Enterprise: ya sea que se migren cargas de trabajo reales o no, según los criterios de evaluación de FinTwit.
- Cómo reaccionan Anthropic y OpenAI: reducciones de precios, cambios en los niveles de esfuerzo, ritmo de lanzamientos. Cualquier modificación en la lista de precios por token es una admitición de presión. Anthropic ya ha clasificado Opus 4.8 en modo rápido.$10 y $50 por millón de tokens, a una velocidad de 2.5x..
- Costo de inferencia por token: ¿La diferencia entre los valores se reducirá o aumentará en los próximos dos trimestres?
Cuando esta historia no importa.
- Si la evaluación multimodal independiente demuestra que los datos utilizados fueron seleccionados de manera selectiva, entonces la afirmación se vuelve inverídica. En ese caso, se puede decir que “DeepSeek se comparó consigo mismo”.
- Si la dependencia en relación con la destilación resulta ser profunda, la narrativa de eficiencia pura se ve socavada, y la brecha de precios no es tan duradera como parece.
- Si los compradores empresariales no sustituyen a Opus 4.8 como opción predeterminada para cargas de trabajo de alto valor y alta importancia, entonces el costo seguirá siendo el mismo.
- Si Anthropic y OpenAI responden más rápido que el crecimiento de la sustitución, entonces el “premium” se defenderá por sí mismo.
La valoración de tipo inversor es una apuesta entre diferentes tendencias, con una dirección específica. Los costos de capital se pagan en función del volumen de negociaciones, y así pueden sobrevivir a los desafíos que surgen. Pero la tarifa por cada token, que financia los márgenes y valoraciones de las empresas en áreas de desarrollo futuro, no parece sostenible cuando el margen de competitividad independiente es de cinco puntos en el índice, y el sustituto está en una posición de equilibrio. Hay que observar el número total, no solo el índice. El arbitraje funciona allí donde realmente se recauda la tarifa.








Comentarios
Aún no hay comentarios