
Sobald DeepSeek das berichtete, funktionierte die Aussage. Sie enthielt den Namen des Entwicklungsteams sowie eine Behauptung bezüglich der Qualität des Produkts. Die Information wurde an dem Tag veröffentlicht, an dem die API-Version freigegeben wurde. Alle Techniknachrichten verglichen diese Aussagen – doch sie vermieden es, den eigentlichen Umfang der Aussagen zu erwähnen. Der Reflex jedes Menschen, der seit Jahren über Keynotes zu Chips und Modellen gehört hat, ist nicht zu fragen, was das Unternehmen tun wird. Der Reflex ist vielmehr zu erfahren, was die Aussage tatsächlich bedeutet – und ob jemand anders diese Aussage überprüft hat.
Am 21. August brachte DeepSeek ein experimentelles Modell namens deepseek-v4-flash-vision-exp auf seiner API-Plattform online. Es wurde angegeben, dass dieses Modell auf den „Multimodale-Agent-Benchmarks“ einen großen Fortschritt gegenüber V4-Flash darstellt.Die Leistung des multimodalen Agenten ist nahe an der von Opus-4.8.."
Lesen Sie den Rest dieser Zeile, bevor das Wort „close“ Sie begeistert. Die Parity-Sprache ist auf Multimodale Agent-Benchmarks beschränkt. Laut der Ankündigung von DeepSeek ist das Modell…Die Textfähigkeiten entsprechen denen des V4-Flash-Modells.Es geht um Agenten, Logik und Weltwissen – nicht um die Eigenschaften von Opus 4.8. Es wird keine Aussagen über allgemeines Intellekt gemacht. Das Modell ist ausdrücklich experimentell. Es wurde keine Benchmark-Tabelle veröffentlicht, und die Vergleichswerte wurden auch nicht bekanntgegeben. Vision-Exp übernimmt die Eigenschaften von V4-Flash: Die Bilder werden in bis zu 384 Tokens aufgeteilt, um die Verwaltung zu erleichtern. Es gibt keine separaten Preise pro Million-Tokens zur Überprüfung.
Die richtige erste Bewertung ist nicht „DeepSeek hat Opus abgeglichen“. Es ist vielmehr: „DeepSeek behauptet das, aber nur in begrenztem Maße – ohne dass es bisher eine unabhängige Bestätigung gibt.“Ein kluges Investor betrachtet die Entfernung zwischen diesen beiden Sätzen als die gesamte „Geschichte“.
Was die einzige unabhängige Messung sagt
Das einzige unabhängige Indikator, der bei der Veröffentlichung verfügbar ist, ist der Artificial Analysis Intelligence Index. Dieser Indikator gibt eine Bewertung an.Claude Opus 4.8: 57 gegen 52Für DeepSeek V4 Flash 0731 – die Modelle Vision-Exp erweitern sich. Fünf Punkte sind zwar ausreichend, um etwas zu erreichen, aber nicht ausreichend, um als „Parität“ zu gelten. Was die allgemeine Intelligenz angeht, so führt Opus 4.8 immer noch an. Anthropic hat Opus 4.8 im Mai versandt.Eine bescheidene, aber messbare Verbesserung.Und es steht auf der Spitze der Rangliste – SWE-Bench Pro mit 69,2 Prozent, Terminal-Bench 2,1 mit 74,6 Prozent. Das ist genau die Situation, in der die hochwertigen Arbeitslasten auftreten. Die „Nähe“ zu einem Index bedeutet nicht, dass ein Basispunkt des Unternehmensverhaltens aus den Händen von Anthropic entfernt wird. Noch nicht.
Aber „näher“ war nie der interessante Aspekt. Das Interessante ist vielmehr, was die gleichen Vergleiche über den Preis aussagen.
Der Unterschied zwischen dem Listepreis und dem tatsächlichen Preis ist das eigentliche Problem.
Auf den Rohpreisen ist der Unterschied enorm. OpenRouter listet DeepSeek V4 Flash auf.0,065 Dollar pro Million Eingabestoken und 0,18 Dollar pro Million AusgabeDie Kosten für die Token sind im Vergleich zu Opus 4.8’n $5 und $25 viel niedriger. Das bedeutet, dass die Kosten für den Eingang etwa 77-mal niedriger sind und die Kosten für den Ausgang etwa 139-mal niedriger sind – im Durchschnitt.
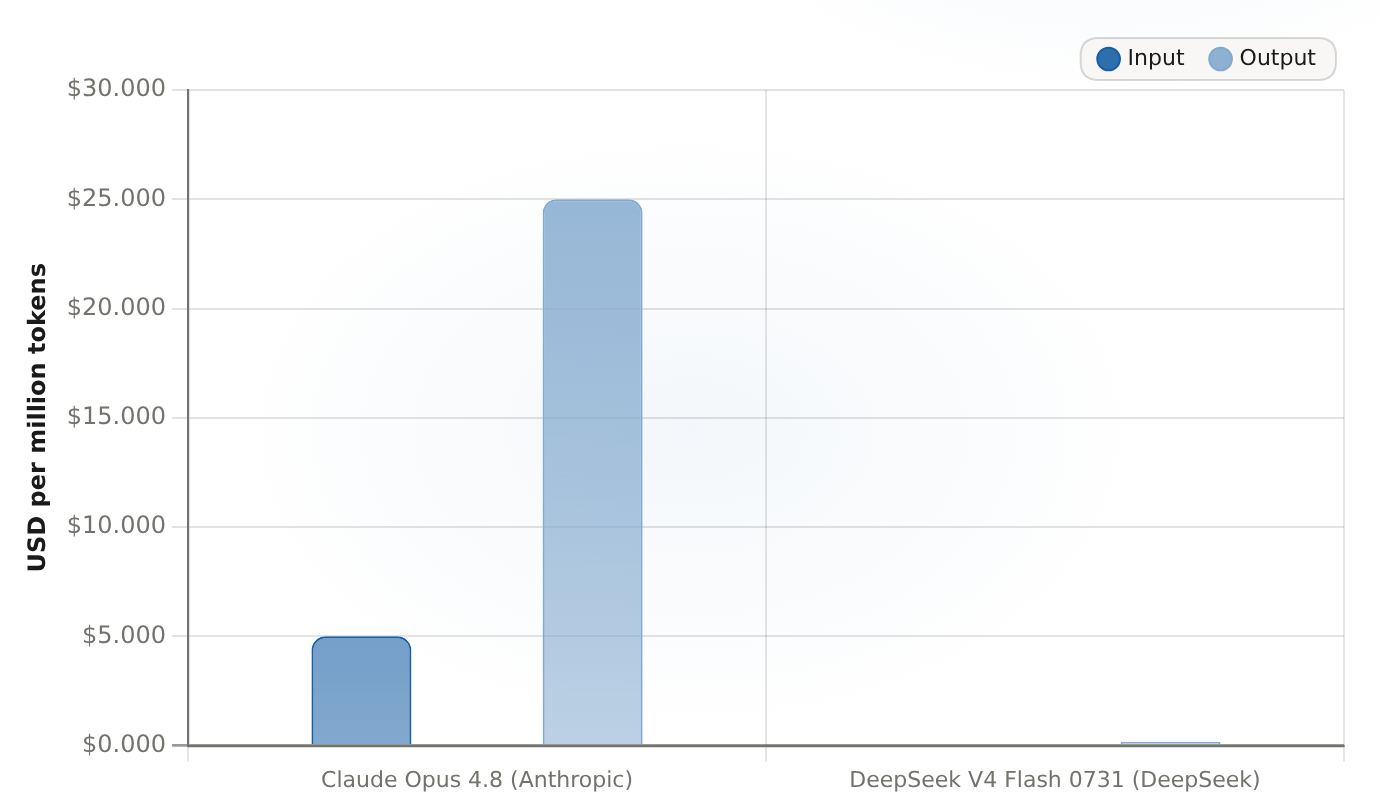
Auf der Rohpreisliste ist DeepSeek V4 Flash etwa 77-mal günstiger bei den Eingabetoken und etwa 139-mal günstiger bei den Ausgabetoken als Claude Opus 4.8.
| Modell | Eingabe | Ausgabe |
|---|---|---|
| Claude Opus 4.8 (Anthropisch) | 5 | 25 |
| DeepSeek V4 Flash 0731 (DeepSeek) | 0.065 | 0.18 |
Der direkte Vergleich der Listen ist wichtig – schließlich basiert die Marketingmathematik auf diesem Vergleich. Doch es handelt sich dabei um eine falsche Grundlage, um die wirtschaftlichen Aspekte eines funktionierenden Käufers zu beurteilen. Caching und eine realistische Token-Mischung können den Unterschied verringern. Die künstliche Analyse ergibt einen effektiven Preis pro Million Tokens – eine Zahl, die anhand des realistischen Verhältnisses von 7:2:1 zwischen Cache-Hit und Input-Output berechnet wird. Damit liegt DeepSeek bei etwa 0,23 Dollar pro Million Tokens, während Opus 4,8 etwa 3,85 Dollar pro Million Tokens kostet – also etwa 16-mal günstiger, nicht 139-mal. Hinzu kommt noch die Geschwindigkeit: Die Ausgabe erfolgt etwa 2,1-mal schneller (133 Tokens pro Sekunde gegenüber 62). Die Zeit bis zum Erreichen des ersten Tokens ist außerdem etwa 34-mal kürzer (1,15 Sekunden gegenüber 38,78 Sekunden).
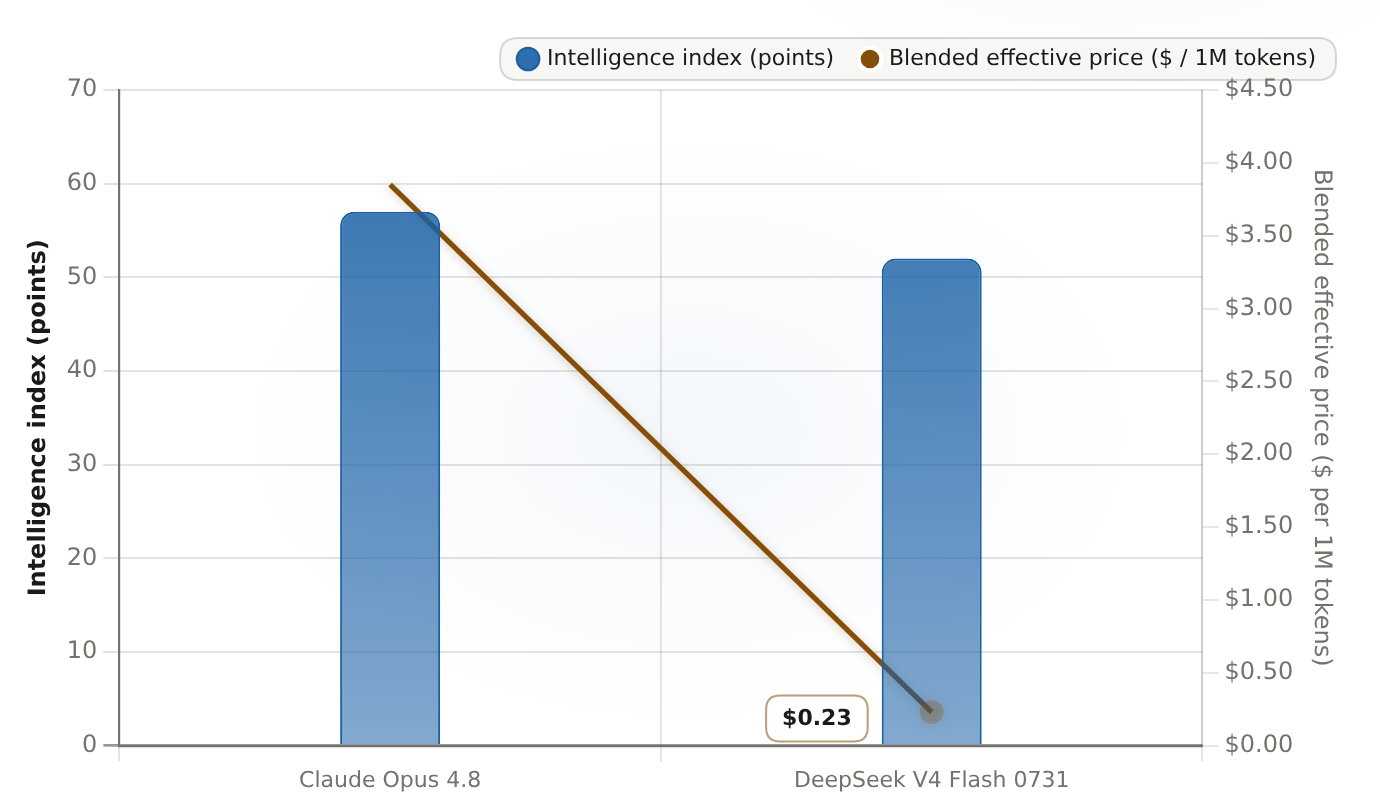
DeepSeek liegt nur 5 Punkte hinter Claude auf der Intelligenzskala. Doch der Preis pro Million Tokens beträgt etwa 16-mal weniger als bei Claude – gemessen am AIA-Blended-Effektpreis.
| Modell | Intelligenzindex (Punkte) | Gesamteffektiver Preis ($ / 1 Mio Tokens) ($) |
|---|---|---|
| Claude Opus 4.8 | 57 | 3.85 |
| DeepSeek V4 Flash 0731 | 52 | 0.23 |
„Blended“ ist das, was ein CFO eines hochvolumigen Coding-Shops tatsächlich zahlt. „List“ ist die Preismacht, die das Frontier-Lab für sich betrachtet. Der Raum zwischen den beiden ist der Arbitrage-Markt.Keine dieser Grundlagen ist „die“ Zahl; jede von ihnen beantwortet eine andere Frage. Die beiden dürfen niemals miteinander vermischt werden.
Die Preisstruktur der Per-Token-Modelle ist das, was unter Druck gerät.
Das Framework pro Einheit wird entwickelt – und das Ziel des „Squeeze“ wird klar. Anthropic bemisst die Produktionswerte in Millionen Token bei 25 Dollar pro Token; der strukturelle Ersatzmarkt bemisst sie hingegen bei 0,18 Dollar pro Token. Die Margen von Frontier-Lab sind eine Art „Eintrittsgebühr“ für die Token. Diese Gebühr wird nun durch einen Kapazitätsunterschied verteidigt – eine Differenz, die durch unabhängige Messungen auf fünf Indexpunkte geschätzt wird. Es handelt sich dabei nicht um eine Barriere, die niemand überwinden kann. Ein API-Käufer, der dieselbe Agentikode-Arbeitslast auf beiden Modellen ausführt, kann ein kleines Sample erneut bewerten. Wenn die unabhängigen Tests zeigen, dass der Unterschied bei dieser Arbeitslast gering ist, dann wird die Gebühr angenommen. Dieser Ersatzmechanismus führt dazu, dass die Prämie zusammengedrückt wird. Offene Gewichte können nicht mit einer Lizenzänderung abgeschaltet werden. Jede Quartalsdatenlage bedeutet, dass die Gebühr schwerer verteidigt werden muss.
Die Effizienz ist tatsächlich vorhanden. Das „Wunder“ wird übertrieben dargestellt.
Das Ergebnis von DeepSeek als effizienter Konkurrent verdient Anerkennung. Die im Januar 2025 veröffentlichten V3 und R1 erreichen…Gleiche Leistung wie GPT-4o und o1 – zumindest zum Preisniveau.R1 ist fast doppelt so schnell wie o1. Dario Amodei selbst gab zu, dass DeepSeek zumindest in manchen Aspekten erfolgreich war.Kommen wir dem Leistungsniveau der US-Frontier-AI-Modelle näher.Zumindest zu niedrigeren Kosten. Das ist das Prinzip eines konkurrierenden Forschungslabors – es wird anerkannt, dass es einen Arbitrageeffekt gibt.
Die ehrlichen Angaben folgen. Der berühmte Wert von 5,576 Millionen Dollar für die Trainingseinheit V3 umfasst nur den erfolgreichen letzten Betrieb des Modells – es schließt dabei die vorherigen Forschungen, Abtrennungen sowie die Infrastruktur aus. Unabhängige Schätzungen, darunter die von CSIS, besagen, dass der tatsächliche Gesamtbetrag über 1 Milliarde Dollar liegt. Die Angabe von 5,576 Millionen Dollar als Kosten für die Modelle von DeepSeek macht das „Wunder“ zu einem Schlagzeilen-Thema. Die Geschichte wird außerdem durch die Anschuldigungen gegen OpenAI belastet – OpenAI bietet „bestimmte Beweise“, die Sicherheitsforscher von Microsoft beobachten, dass große Mengen an Daten über APIs weitergegeben werden, und die Modelle von DeepSeek geben an, dass sie auf der Architektur von GPT-4 basieren. Das wirft die Frage auf, wie viel der Effizienzausbau auf der nativen Architektur beruht und wie viel auf genutzten Signalen. Die „Distillation“-Prozess bedeutet, ein Studentenmodell auf den Ausgaben eines größeren „Lehrers“ zu trainieren. Wenn das der eigentliche Mechanismus ist, dann ist der Kostenvorteil teilweise „vermietet“ – nicht selbst entwickelt.
Der technische Aufbau ist wirklich einfach: Die V4-Familie ist ein eher weniger ausgeprägtes „Mixture-of-Experts“-Modell.284 Milliarden GesamtparameternMit etwa 13 Milliarden aktivierten Einheiten pro Token und einem Kontext von 1 Million Tokens – wobei jeder Inferenzschritt nur einen kleinen Teil der Gewichte berührt – wurde DeepSeek auf H800-Klasse-Silizium entwickelt, das den Anforderungen der Exportvorschriften entspricht. Gleichzeitig hat DeepSeek jedoch eine etwa 4-fach größere Rechenleistung als US-Unternehmen.Architektur – nicht Glück. Nur Architektur unter einem Sternchen, bis die Frage bezüglich der Destillation geklärt ist.
Die Theorie bezüglich der Investitionen übersteht die Herausforderungen.
Hier machen die meisten Investoren den Fehler. Das instinktive Ergebnis ist, dass günstigere Token das Entwickeln von KI-Systemen behindern könnten – ein Verhalten, das Nvidia im Januar 2025 um 18 Prozent abwärts trieb aufgrund des Panics bezüglich DeepSeek. Die Strategien der großen Cloud- und AI-Anbieter weisen jedoch eine andere Richtung auf. Laut den Prognosen von Futurum betragen die Investitionen der fünf größten US-Cloud- und AI-Anbieter – Microsoft, Alphabet, Amazon, Meta, Oracle – im Jahr 2026.660 Milliarden bis 690 MilliardenEtwa das Dreifache von den etwa 380 Milliarden Dollar im Jahr 2025. Die Anzahl der Investitionen von Value Add VC in Unternehmen wie Amazon, Microsoft, Alphabet und Meta ist noch höher.Rund 760 Milliarden Dollar – ein Anstieg von 85 Prozent gegenüber etwa 410 Milliarden Dollar.Die Bedingungen unterscheiden sich, daher hat jede Zahl ihre eigene Bedeutung. Alle fünf Anbieter beschreiben ihre KI-Märkte als solche mit begrenzter Nachfrage – nicht mit begrenzter Nachfrage nach Produkten. Microsoft verfügt über einen Bestand von 80 Milliarden Dollar an Azure-Diensten, der durch technische Probleme behindert wird. Alphabet hat die Kosten für den Betrieb von Gemini im Jahr 2025 um 78 Prozent reduziert, während sie den Investitionsplan weiterhin erhöhen.
Das Paradoxon bei Jevons ist folgendes: Kostengünstigere Einheiten eines Produkts führen zu einer höheren Gesamtkonsummierung. Die Effizienz verringert den Kosten pro Einheit, während der Verbrauch steigt – und die gesamte Nachfrage nach der Nutzung der Technologie wächst schneller, als die Kosten pro Einheit sinken. Die Effizienz eliminiert das Problem nicht; sie vergrößert vielmehr die Arbeitslast, die mit der Implementierung der Technologie verbunden ist. Es lohnt, dies klar zu sagen für diejenigen, die 2025 abgelehnt haben und auf einen effizienteren Wettbewerber warteten, der das Investitionsproblem der KI-Technologie lösen könnte.Die Punktion erfolgt nicht von der Seite des Theses, wo die Struktur entsteht.

Was die Beweise unter Druck zeigen
Die Gesamtschätzung lässt sich in zwei Teile unterteilen. Der Aufbau der Infrastruktur übersteht den „efficient-challenger-Schock“ – das nahezu verdoppelte Capex für das Jahr 2026 ist die Antwort des Marktes auf die Effizienznarrative. Der Teil, der betroffen ist, ist der Preis pro Token, den Anthropic und OpenAI für ihre Top-Modelle verlangen – was die Bezeichnung „Frontier-Index-Pricing-Kraft“ darstellt. Dies basiert auf einem fünfpunktigen Indexunterschied, wobei der Preis bei 77x bis 139x Listpreis liegt und etwa 16x gemischter Preis. Der Ersatz kann nicht abgeschaltet werden. Beachten Sie den Ungleichgewicht zwischen den Skalen: OpenAIs jährliche Einnahmen von etwa 20 Milliarden Dollar entsprechen etwa 3 Prozent des Capex der Hyperscalers im Jahr 2026. Somit hängt der Aufbau nicht von diesen Kosten ab.Das Volumen bleibt erhalten; die Preisgestaltung ist das anfällige Element.
Watchlist: 6 bis 12 Monate
- Unabhängige Bewertung von Vision-Exp – künstliche Analyse, LMArena, externe Überprüfung der Ergebnisse des Multimodalen Agenten. Das ist die erste echte Prüfung dieser Behauptung.
- Ob DeepSeek seine Benchmark-Tabelle sowie die Vergleichswerte veröffentlicht, ist unklar. Ohne diese Informationen bleibt „fast wie Opus 4.8“ unbelegbar.
- Die Einführung der DeepSeek-APIs und -Werte durch Enterprise-Unternehmen – unabhängig davon, ob echte Arbeitslasten übertragen werden oder nicht.
- Wie Anthropic und OpenAI reagieren: Preissenkungen, Änderungen bezüglich der Kostenstruktur, Veränderungen im Zeitplan für die Veröffentlichung. Jede Veränderung in der aufgeführten Liste der Kosten pro Token ist eine Anerkennung dafür, dass Druck besteht – Anthropic hat bereits den Opus 4.8 Fast-Modus in einer bestimmten Kostenstruktur eingestellt.10 und 50 Dollar pro Million Tokens bei einer Geschwindigkeit von 2,5x.
- Kosten der Inferenz pro Token – ob die Differenz zwischen den beiden Quartalen zunimmt oder abnimmt.
Wenn diese Geschichte keine Bedeutung hat…
- Wenn eine unabhängige, mehrfache Bewertung zeigt, dass die „Nähe“ nur ausgewählt wurde, dann fällt die Aussage in den Bereich „DeepSeek hat sich selbst abgeglichen“.
- Wenn die Abhängigkeit von der Destillation tief ist, dann wird die „reine Effizienz“-These untergraben und der Preisunterschied bleibt nicht so stabil wie es scheint.
- Wenn die Unternehmenskäufer keine Verdrängung bewirken – wenn Opus 4.8 weiterhin die Standardlösung für hochwertige, anspruchsvolle Workloads bleibt – dann bleibt der Preis unverändert.
- Wenn Anthropic und OpenAI schneller reagieren als die Anzahl der Substitutionen zunimmt, dann kann sich das „Premium“ selbst verteidigen.
Die „Investor-Grade-Read“ ist eine Art „Cross-Currents-Call“, bei dem eine bestimmte Richtung dominiert. Die Capex-Posten werden nach dem Volumen ausgezahlt und überstehen die effizienten Konkurrenzangebote. Der Betrag pro Token, der dazu dient, die Margen und Bewertungen der neuen Angebote zu finanzieren, scheint nicht langfristig haltbar zu sein – insbesondere bei einem Premium von 16x bis 139x, wobei der Unterschied zwischen den Indizes nur fünf Punkte beträgt und die Alternative noch nicht vollständig etabliert ist. Achten Sie auf die Gesamtzahl, nicht auf die Indexwerte – der Arbitrage gilt dort, wo tatsächlich Geld eingesetzt wird.








Kommentare
Noch keine Kommentare